요약
트래픽이 늘어서 생기는 문제보다, 사람이 늘어서 생기는 문제를 더 많이 다뤘습니다.
배포를 막는 대신 되돌리기 쉽게 만드는 쪽을 택합니다. 장애 회고에서 "확인 절차를 강화한다"는 문장을 쓰지 않으려고 합니다 — 그 문장이 쓰인 뒤 같은 장애가 다시 나는 것을 여러 번 봤습니다.
아래 숫자는 최근 12개월 동안 맡은 결제 클러스터 기준입니다.
자격 · 검증
이 직군에서는 자격증이 장식이 아니라 스크리닝 기준이라, 위쪽에 둡니다.
- 2025.09CKA — Certified Kubernetes Administrator
- 2024.11AWS Certified Solutions Architect – Professional
- 2023.06AWS Certified DevOps Engineer – Professional
- 2022.03HashiCorp Certified: Terraform Associate
도구 체인
운영 환경에 올려 본 것만 적었습니다. 옆의 작은 글씨는 규모입니다.
구성과 사고 기록
 운영중
멀티 리전 구성
TerraformEKSAurora Global
한 리전이 통째로 죽어도 서비스가 남게
↗ 링크
 완료
결제 지연 장애 회고
Argo RolloutsPagerDuty
감지 2분 · 완화 9분 · 복구 41분
↗ 링크
 운영중
배포 파이프라인
GitHub ActionsTrivyArgo CD
게이트를 통과해야 다음 단계로
↗ 링크
 운영중
SLO와 에러 예산 운영
PrometheusGrafanaAlertmanager
남은 예산이 이번 주 배포 속도를 정합니다
↗ 링크
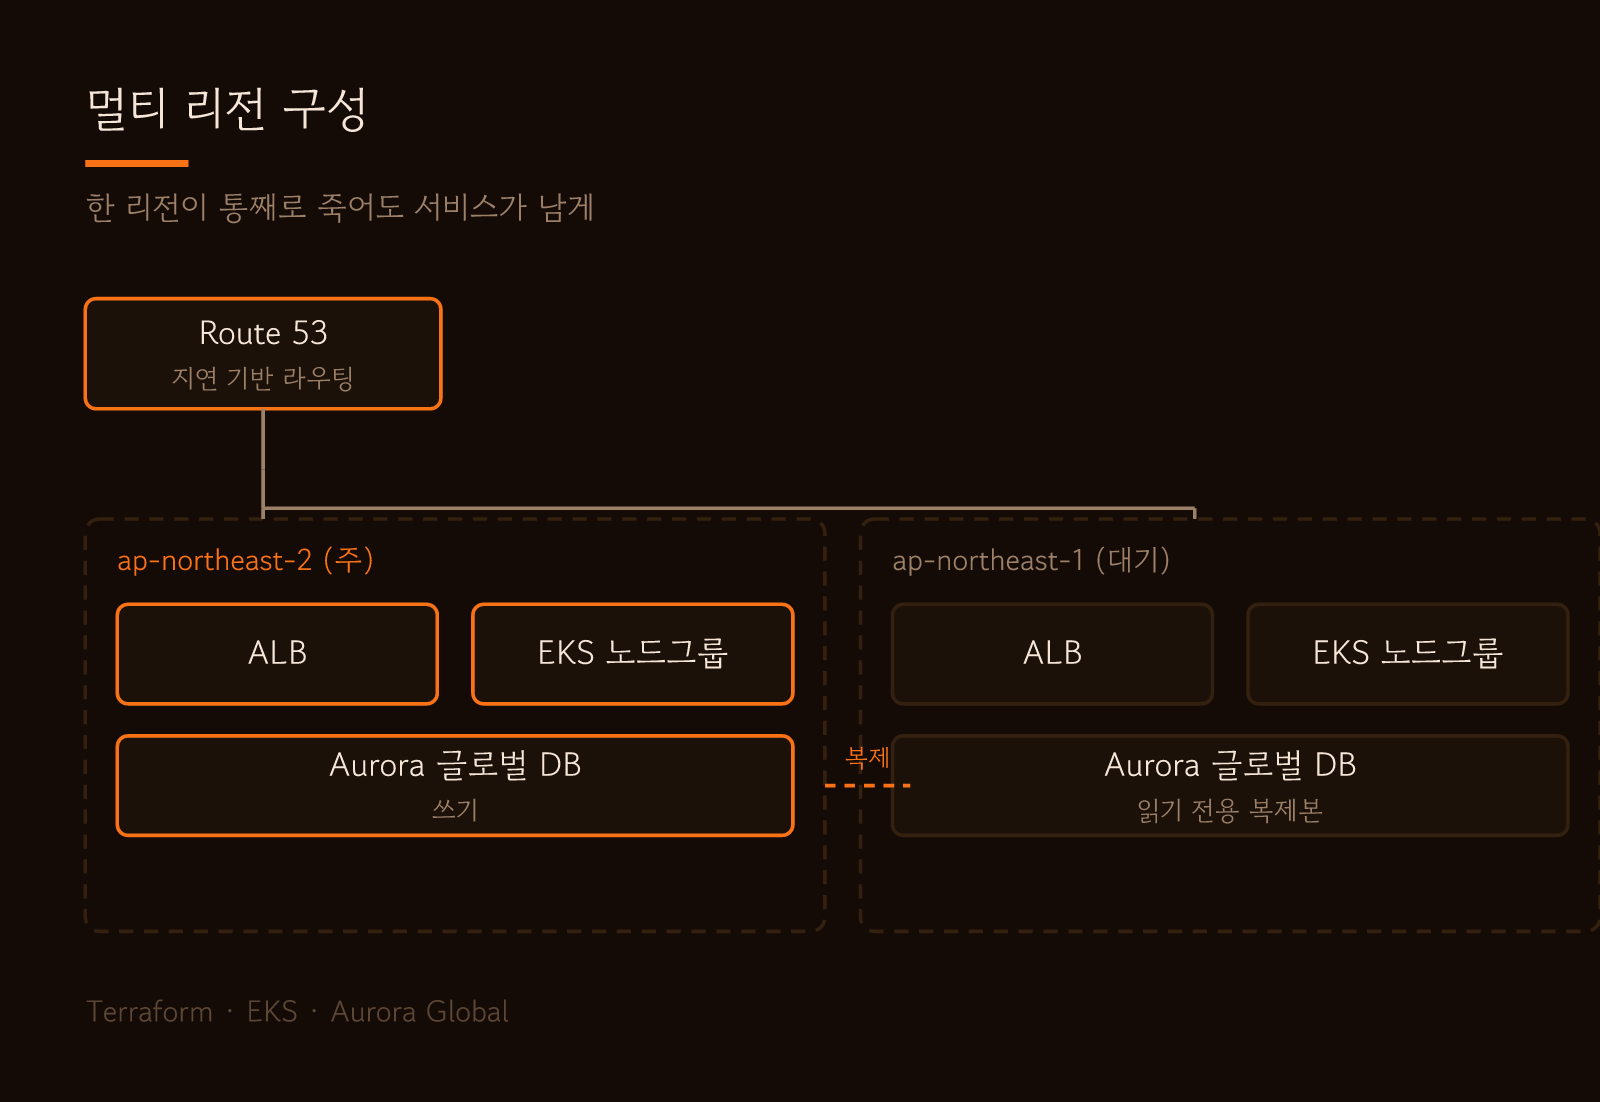
멀티 리전 구성
Terraform · EKS · Aurora Global
왜 — 단일 리전에서 90분 장애를 겪은 뒤였습니다. 그때 우리가 할 수 있는 일은 기다리는 것뿐이었습니다.
어떻게 — 주 리전과 대기 리전을 두고 Aurora 글로벌 데이터베이스로 복제했습니다. 라우팅은 지연 기반으로 두되, 장애 시에는 헬스 체크로 넘깁니다.
결정과 맞바꾼 것 — 비용이 약 1.6배 늘었습니다. 대기 리전을 최소 규모로 두고 장애 시 자동으로 키우는 방식으로 절충했습니다. 완전 이중화가 아니라 "죽지는 않는" 수준을 목표로 잡은 것이 이 설계의 핵심입니다.
검증 — 분기마다 리전 하나를 일부러 끊는 훈련을 합니다. 첫 훈련에서 전환에 22분이 걸렸고, 지금은 6분입니다.
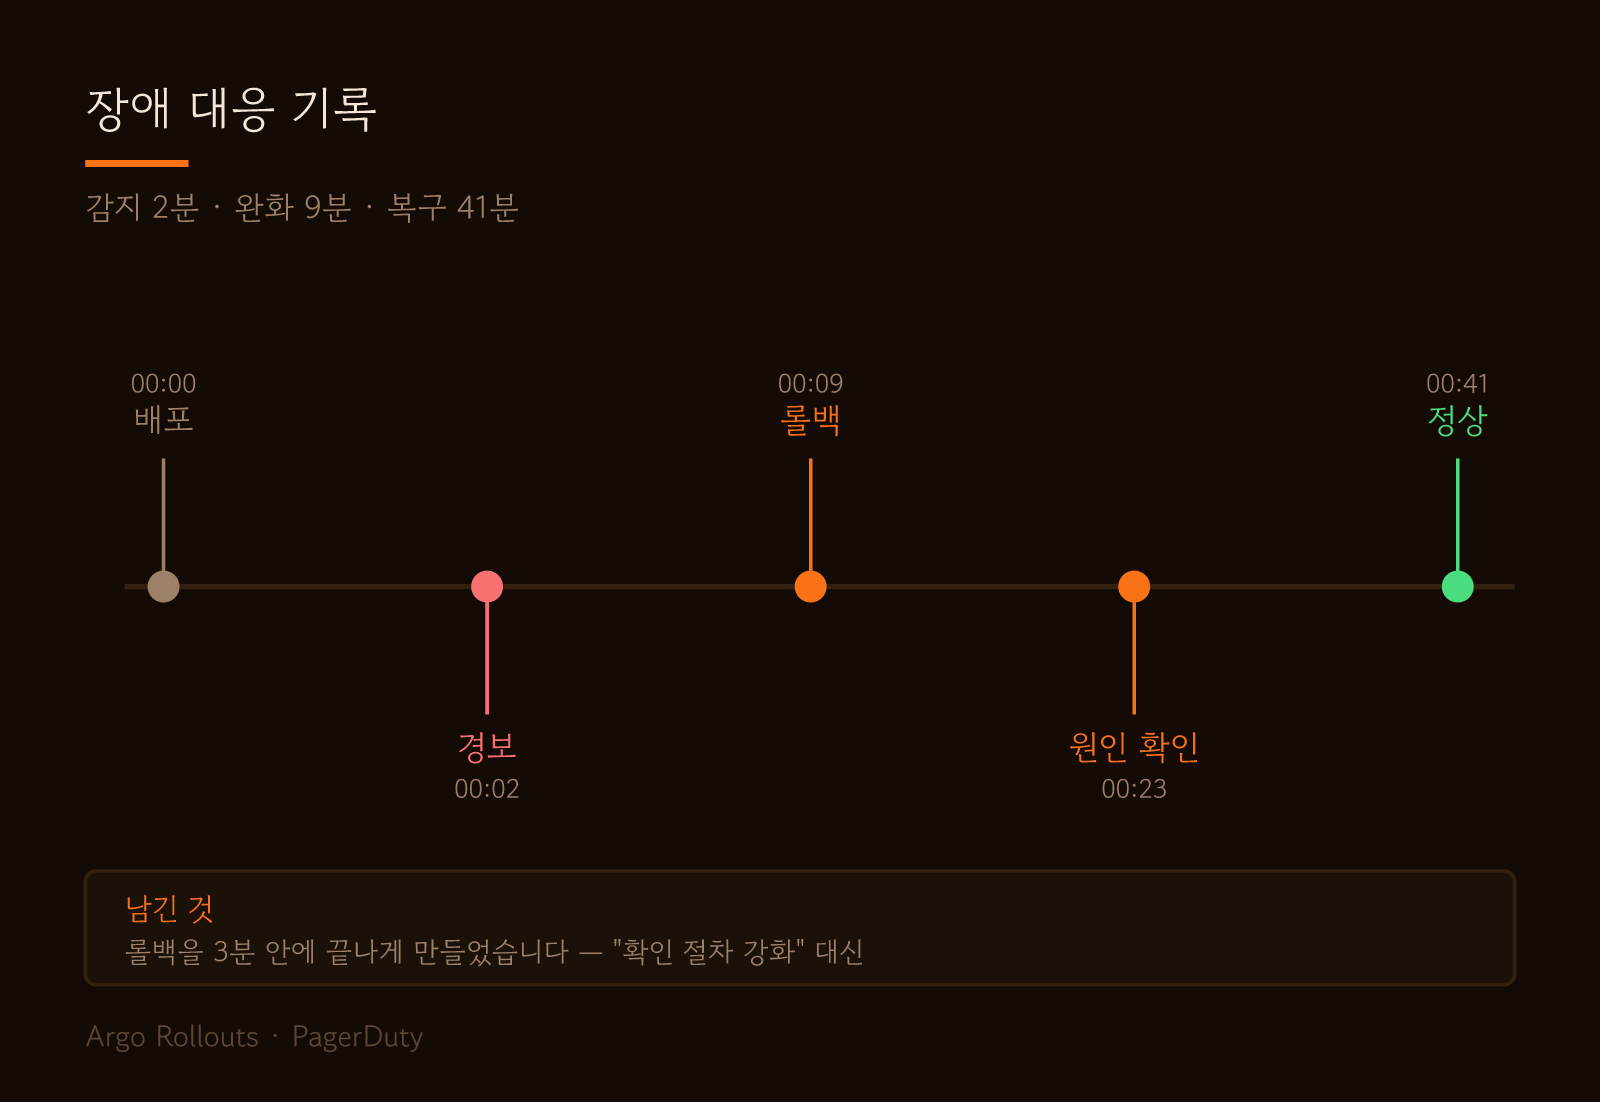
결제 지연 장애 회고
Argo Rollouts · PagerDuty
무슨 일이 — 배포 직후 결제 응답이 3초를 넘기기 시작했습니다. 실패는 아니고 느려지기만 해서 헬스 체크는 정상이었습니다.
왜 늦게 알았나 — 경보가 오류율에만 걸려 있었습니다. 느려지는 것은 아무도 보고 있지 않았습니다.
어떻게 — p95 지연 경보를 먼저 추가하고 롤백했습니다. 원인은 커넥션 풀 크기를 줄인 변경이었는데, 스테이징에는 트래픽이 적어 드러나지 않았습니다.
남긴 것 — "확인을 강화한다" 대신 두 가지를 바꿨습니다. 롤백을 3분 안에 끝나게 만들었고, 스테이징에 운영 트래픽의 5%를 복제해 흘립니다.
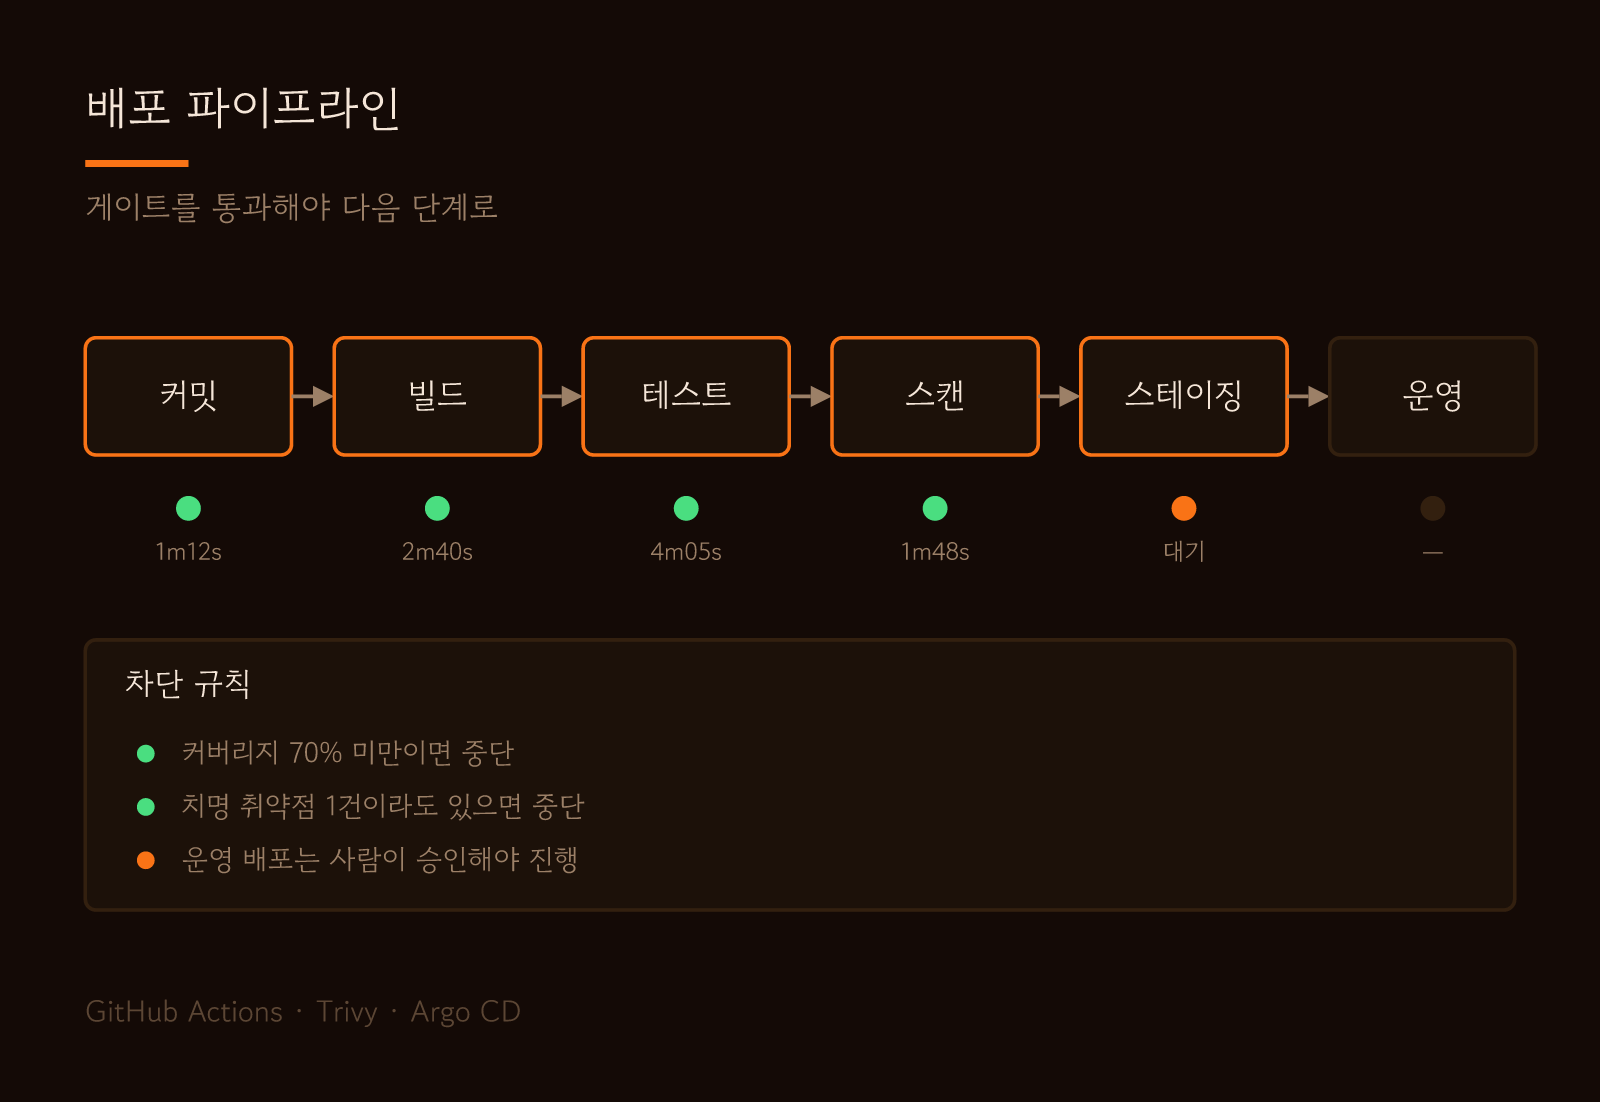
배포 파이프라인
GitHub Actions · Trivy · Argo CD
문제 — 젠킨스 잡이 40개였고, 무엇이 무엇을 배포하는지 아는 사람이 두 명뿐이었습니다.
어떻게 — 파이프라인을 저장소 안 선언으로 옮기고, 차단 규칙을 세 개만 남겼습니다. 커버리지 70% 미만 중단, 치명 취약점 발견 시 중단, 운영 배포는 사람 승인.
일부러 하지 않은 것 — 규칙을 더 늘리지 않았습니다. 게이트가 많아지면 사람들은 우회로를 만듭니다.
결과 — 배포 준비 시간이 평균 26분에서 9분이 됐고, 주간 배포 횟수가 3배가 됐습니다.
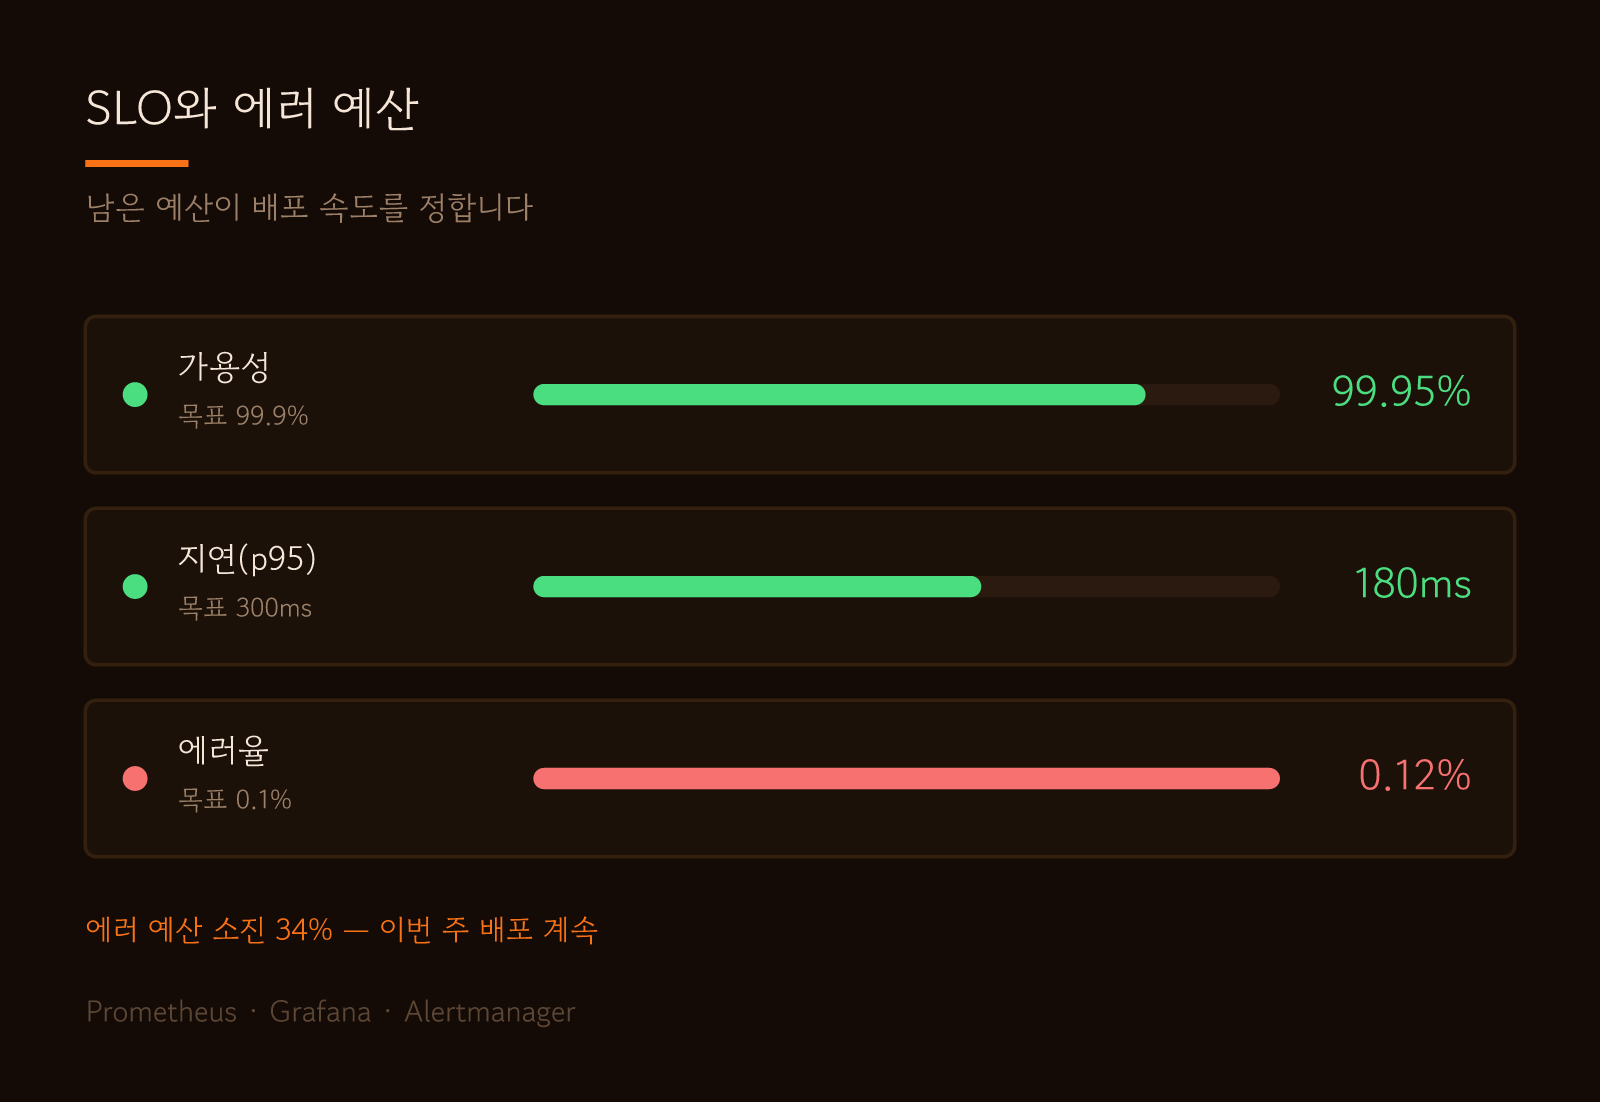
SLO와 에러 예산 운영
Prometheus · Grafana · Alertmanager
왜 — 경보가 하루 60건씩 오면 아무도 안 봅니다. 무뎌지는 것이 가장 위험합니다.
어떻게 — 지표를 세 개로 줄였습니다. 가용성, p95 지연, 오류율. 각각에 목표를 두고 에러 예산을 계산합니다.
운영 규칙 — 예산이 절반 넘게 남으면 배포를 계속하고, 80% 이상 소진되면 기능 배포를 멈추고 안정화만 합니다. 논쟁이 아니라 숫자가 결정하게 만든 것이 핵심입니다.
결과 — 경보가 하루 평균 4건이 됐습니다. 줄어든 것이 아니라, 사람이 볼 필요 없는 것을 뺀 것입니다.
일할 때 지키는 것
1. 하나 — 되돌릴 수 없는 변경은 배포하지 않습니다. 되돌리기가 어려우면 그것부터 만듭니다.
둘 — 사람이 볼 필요 없는 경보는 지웁니다. 경보의 가치는 개수가 아니라 신뢰도입니다.
셋 — 문서는 장애 중에 읽을 수 있어야 합니다. 런북은 배경 설명 없이 명령부터 나오게 씁니다.
넷 — 새로 온 사람이 첫 주에 배포해 볼 수 있어야 합니다. 그게 안 되면 파이프라인이 복잡한 것입니다.
2. 하나 — 되돌릴 수 없는 변경은 배포하지 않습니다. 되돌리기가 어려우면 그것부터 만듭니다.
둘 — 사람이 볼 필요 없는 경보는 지웁니다. 경보의 가치는 개수가 아니라 신뢰도입니다.
셋 — 문서는 장애 중에 읽을 수 있어야 합니다. 런북은 배경 설명 없이 명령부터 나오게 씁니다.
넷 — 새로 온 사람이 첫 주에 배포해 볼 수 있어야 합니다. 그게 안 되면 파이프라인이 복잡한 것입니다.